GenAI-Datenlecks: Wenn Mitarbeitende vertrauliche Daten in KI-Tools einfügen


Subscribe to newsletter
Generative KI-Tools wie ChatGPT, Claude und Copilot sind längst alltägliche Assistenten am Arbeitsplatz. Für viele Unternehmen hat dieser Komfort jedoch einen versteckten Preis: Sensible Unternehmensdaten gelangen per einfachem Copy-and-paste unbemerkt in öffentliche KI-Modelle. Angetrieben durch menschliches Verhalten und Lücken in der Governance entsteht so ein Cyberrisiko, das klassische Sicherheitstools nicht erkennen.
In diesem Beitrag beleuchten wir das wachsende Phänomen der GenAI-Datenlecks im Detail: was genau dahintersteckt, welche Arten sensibler Daten am häufigsten offengelegt werden, welche gravierenden Folgen Unternehmen drohen, welche realen Vorfälle es bereits gab und welche menschlichen Verhaltensweisen das Risiko treiben. Vor allem zeigen wir, wie Human Risk Intelligence (HRI) eine moderne, proaktive Verteidigung bietet, damit Unternehmen das Potenzial von KI sicher nutzen können, ohne ihre Sicherheit zu gefährden.
Was genau ist ein GenAI-Datenleck?
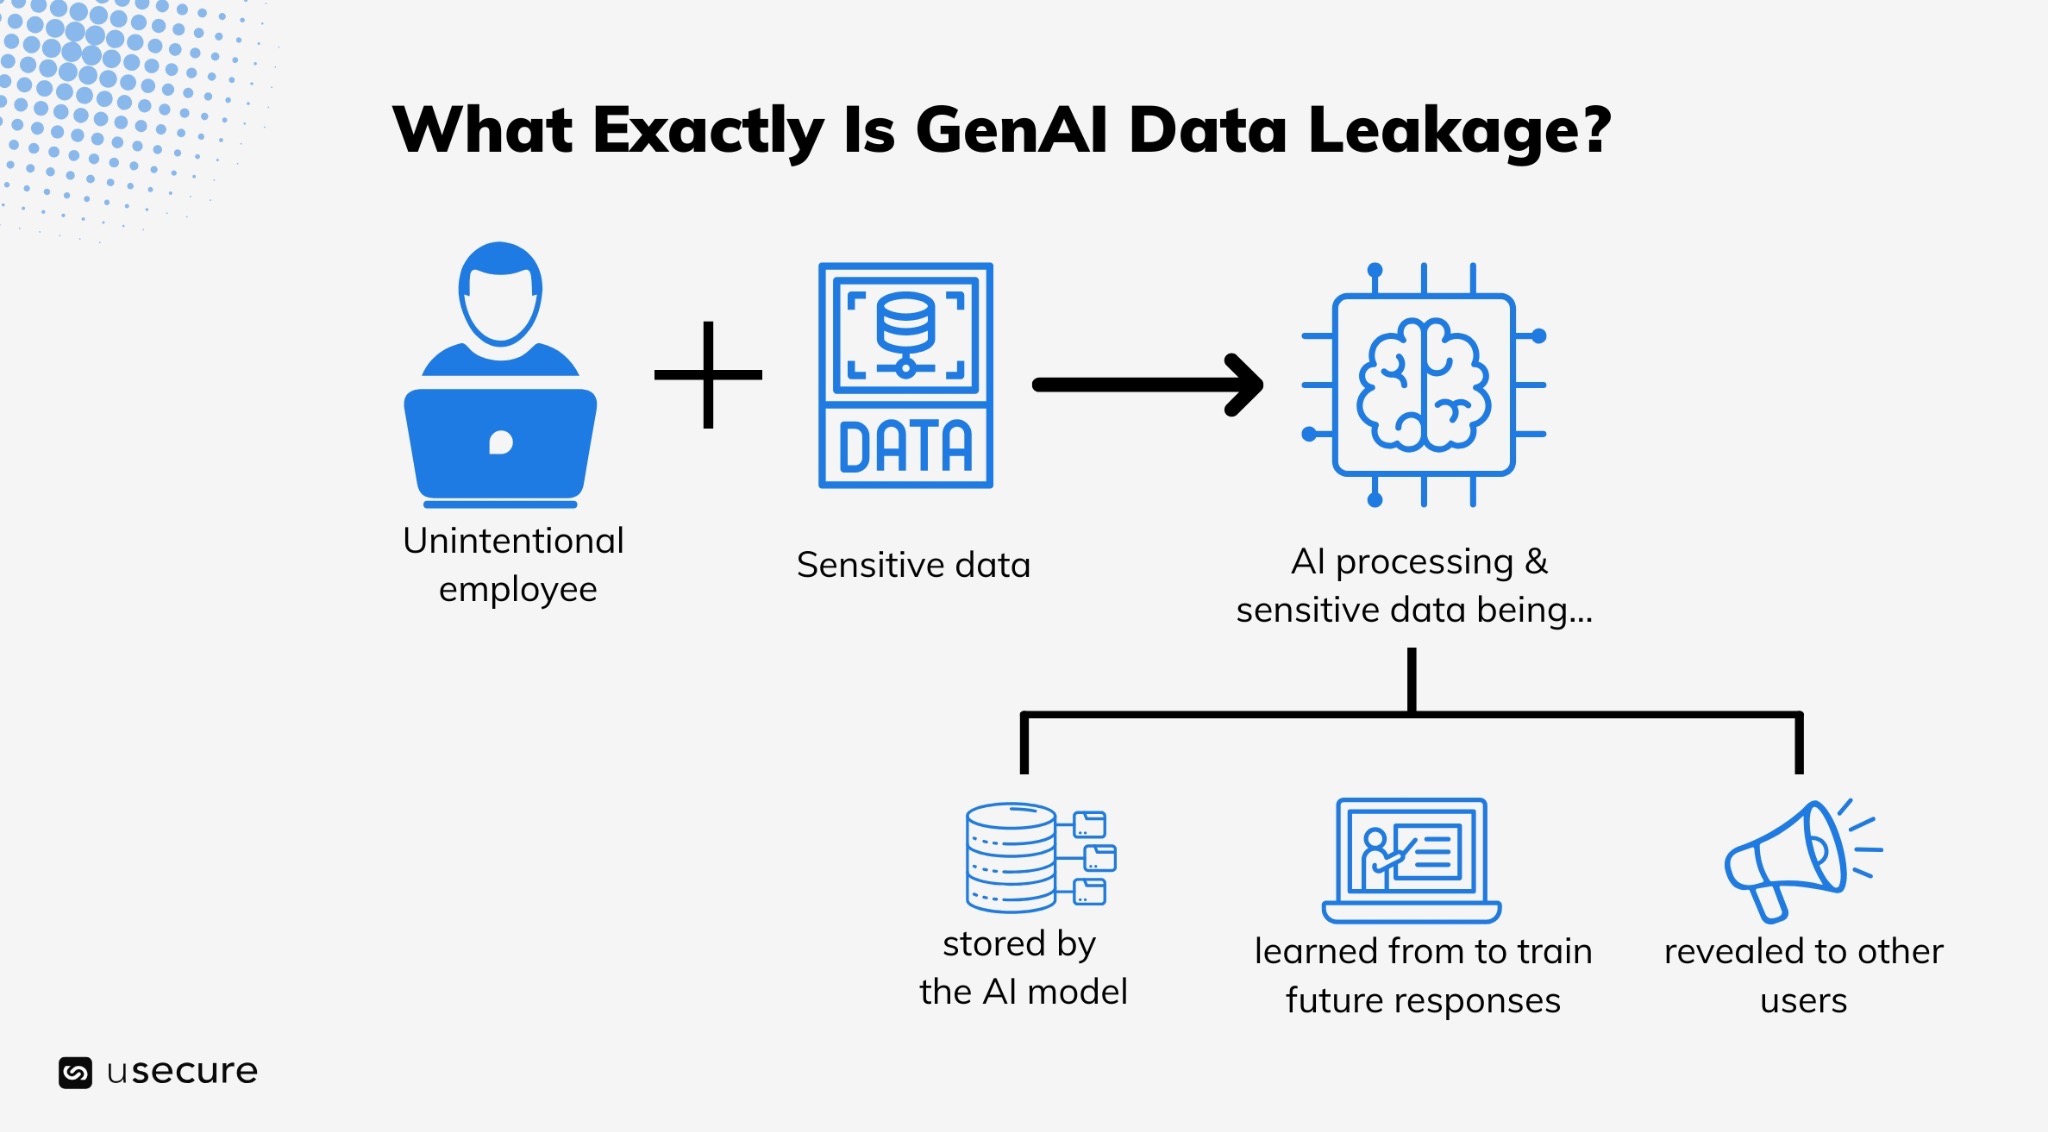
Von einem GenAI-Datenleck spricht man, wenn sensible oder vertrauliche Informationen unbeabsichtigt über generative KI-Systeme offengelegt werden – bei der Eingabe, der Verarbeitung oder der Ausgabe.
Gemeint sind Daten, die Mitarbeitende eigentlich nicht teilen wollten und die dann von einem KI-Modell gespeichert, zum Lernen verwendet oder preisgegeben werden. Einmal übermittelt, verschwinden die Daten nicht. Öffentliche Modelle speichern sie, sofern dies nicht ausdrücklich unterbunden wird, und viele kostenlose Konten fließen direkt in Trainingsdatensätze ein. Selbst „private“ Enterprise-Versionen bergen Risiken, wenn sie falsch konfiguriert sind.
Anders als bei klassischen Sicherheitsvorfällen durch versierte Angreifer geschieht diese Art von Datenabfluss meist unbeabsichtigt. Die Mitarbeitenden handeln nicht böswillig – sie wollen einfach schneller arbeiten.
8 Arten sensibler Daten, die häufig in KI-Tools landen
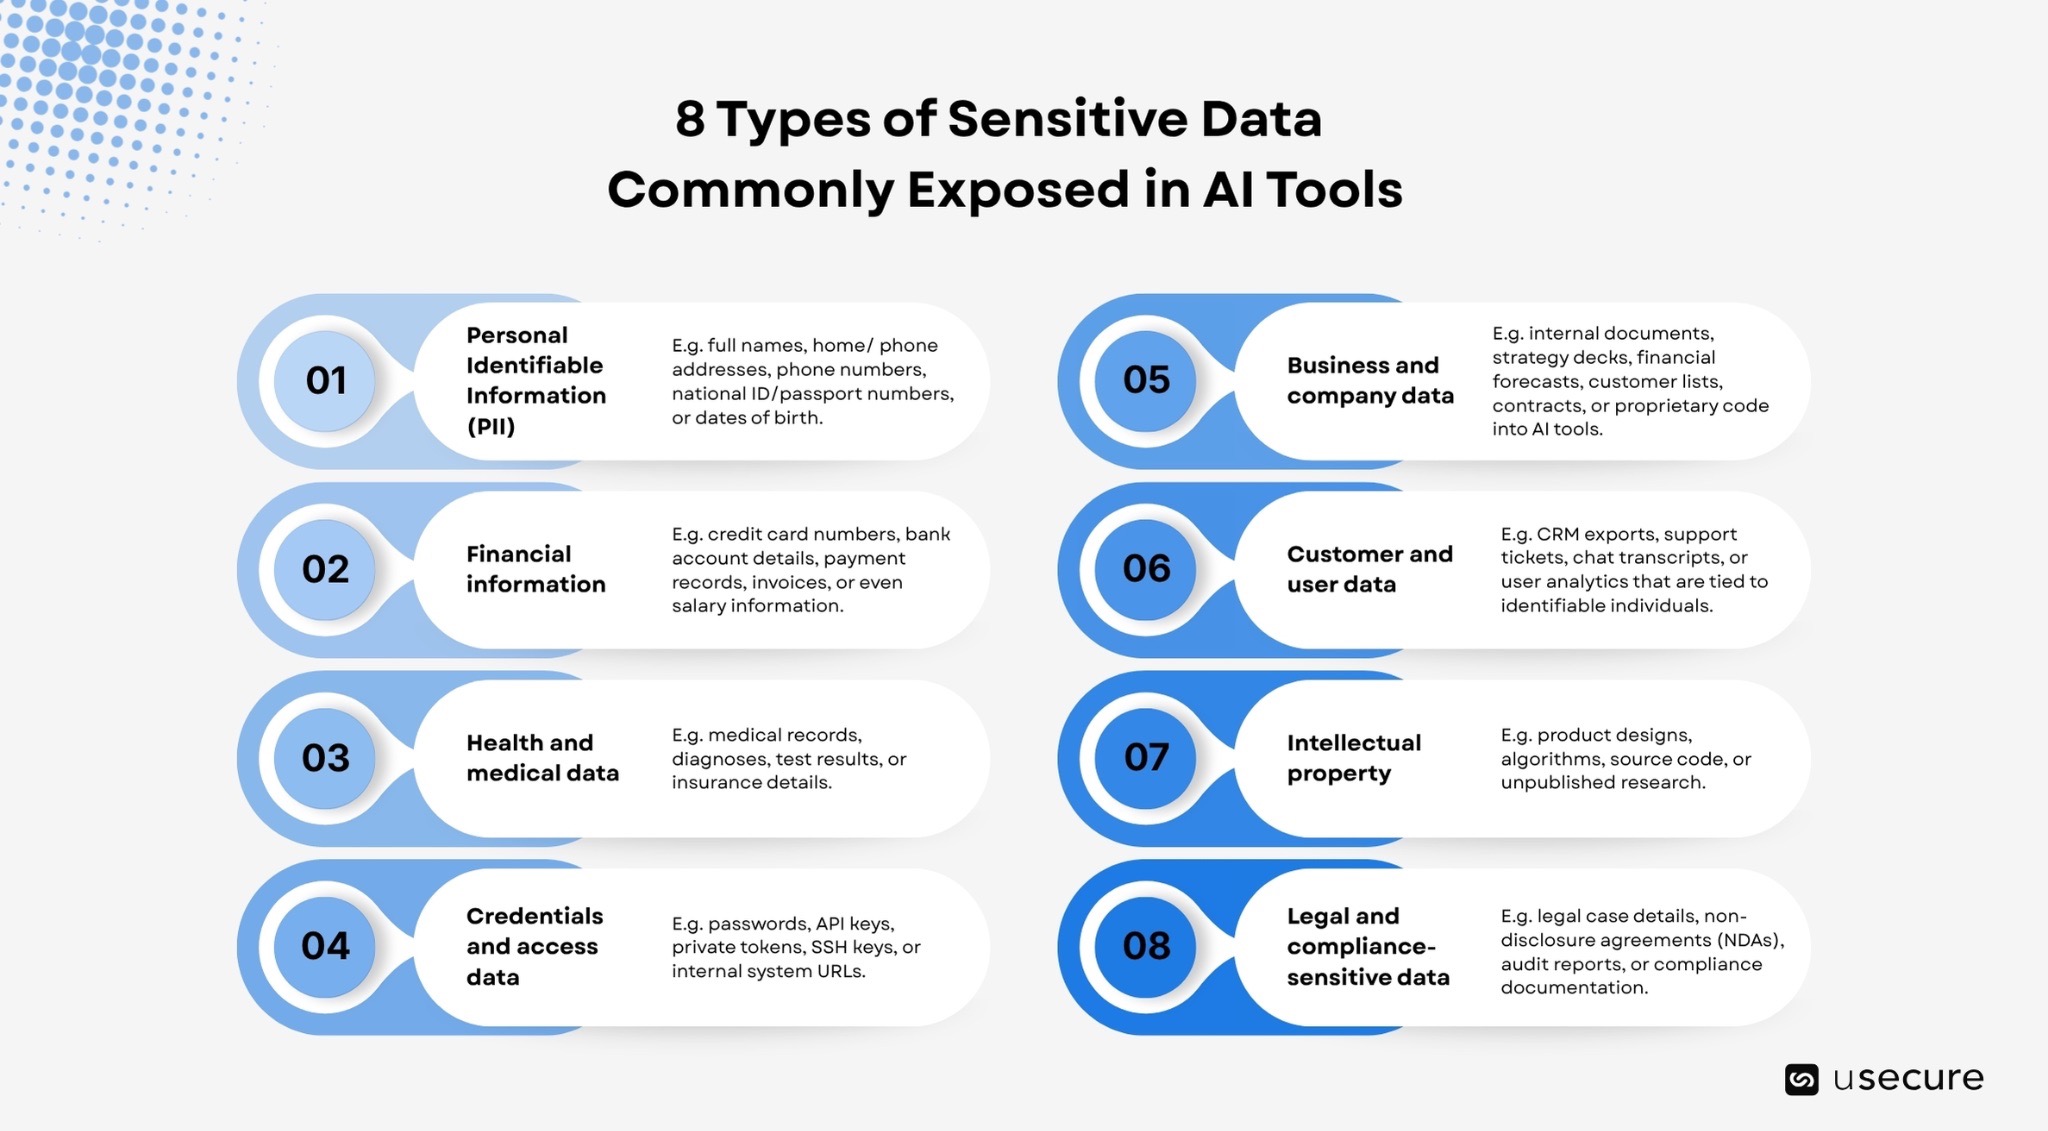
Mitarbeitende unterschätzen oft, wie viele sensible Daten sie in KI-Tools einfügen. Es geht nicht nur um Passwörter – mehrere Kategorien werden regelmäßig offengelegt:
- Personenbezogene Daten (PII): Dazu zählen vollständige Namen, Wohnadressen, Telefonnummern, E-Mail-Adressen, Ausweis- oder Reisepassnummern, Geburtsdaten usw.
- Finanzinformationen: Mitarbeitende fügen mitunter Kreditkartennummern, Bankverbindungen, Zahlungsbelege, Rechnungen oder sogar Gehaltsdaten in KI-Tools ein, um sie verarbeiten oder auswerten zu lassen. Diese Daten sind für Angreifer besonders wertvoll und können bei einer Offenlegung schwerwiegende Folgen haben.
- Gesundheits- und medizinische Daten: Dazu gehören Krankenakten, Diagnosen, Untersuchungsergebnisse oder Versicherungsangaben. Diese Daten sind streng reguliert und müssen nach Vorgaben wie der GDPR oder HIPAA besonders sorgfältig behandelt werden.
- Zugangsdaten und Anmeldeinformationen: Dazu zählen Passwörter, API-Schlüssel, private Tokens, SSH-Schlüssel und interne System-URLs, die Anmeldeinformationen enthalten können.
- Geschäfts- und Unternehmensdaten: Dazu gehören interne Dokumente, Strategiepräsentationen, Finanzprognosen, Kundenlisten, Verträge oder proprietärer Code.
- Kunden- und Nutzerdaten: Dazu zählen CRM-Exporte, Support-Tickets, Chatverläufe und Nutzungsanalysen, die sich identifizierbaren Personen zuordnen lassen. Die Weitergabe solcher Daten kann gegen Datenschutzvorschriften und Unternehmensrichtlinien verstoßen.
- Geistiges Eigentum: Dazu gehören Produktdesigns, Algorithmen, Quellcode und unveröffentlichte Forschungsergebnisse. Auch wenn diese Informationen nicht im klassischen Sinne „sensibel“ wirken, kann ihre Offenlegung die Wettbewerbsfähigkeit eines Unternehmens schwächen.
- Rechts- und compliance-relevante Daten: Dazu zählen Details zu Rechtsfällen, Geheimhaltungsvereinbarungen (NDAs), Auditberichte und Compliance-Dokumentation.
Solche Daten landen meist deshalb in KI-Tools, weil Mitarbeitende schneller vorankommen wollen. Dabei vergessen sie oft, dass die Daten selbst sensibel sind. Eine einfache Faustregel hilft: Was Sie nicht öffentlich im Internet posten würden, gehört auch nicht in ein nicht freigegebenes KI-Tool.
Die gravierenden Folgen von GenAI-Datenlecks
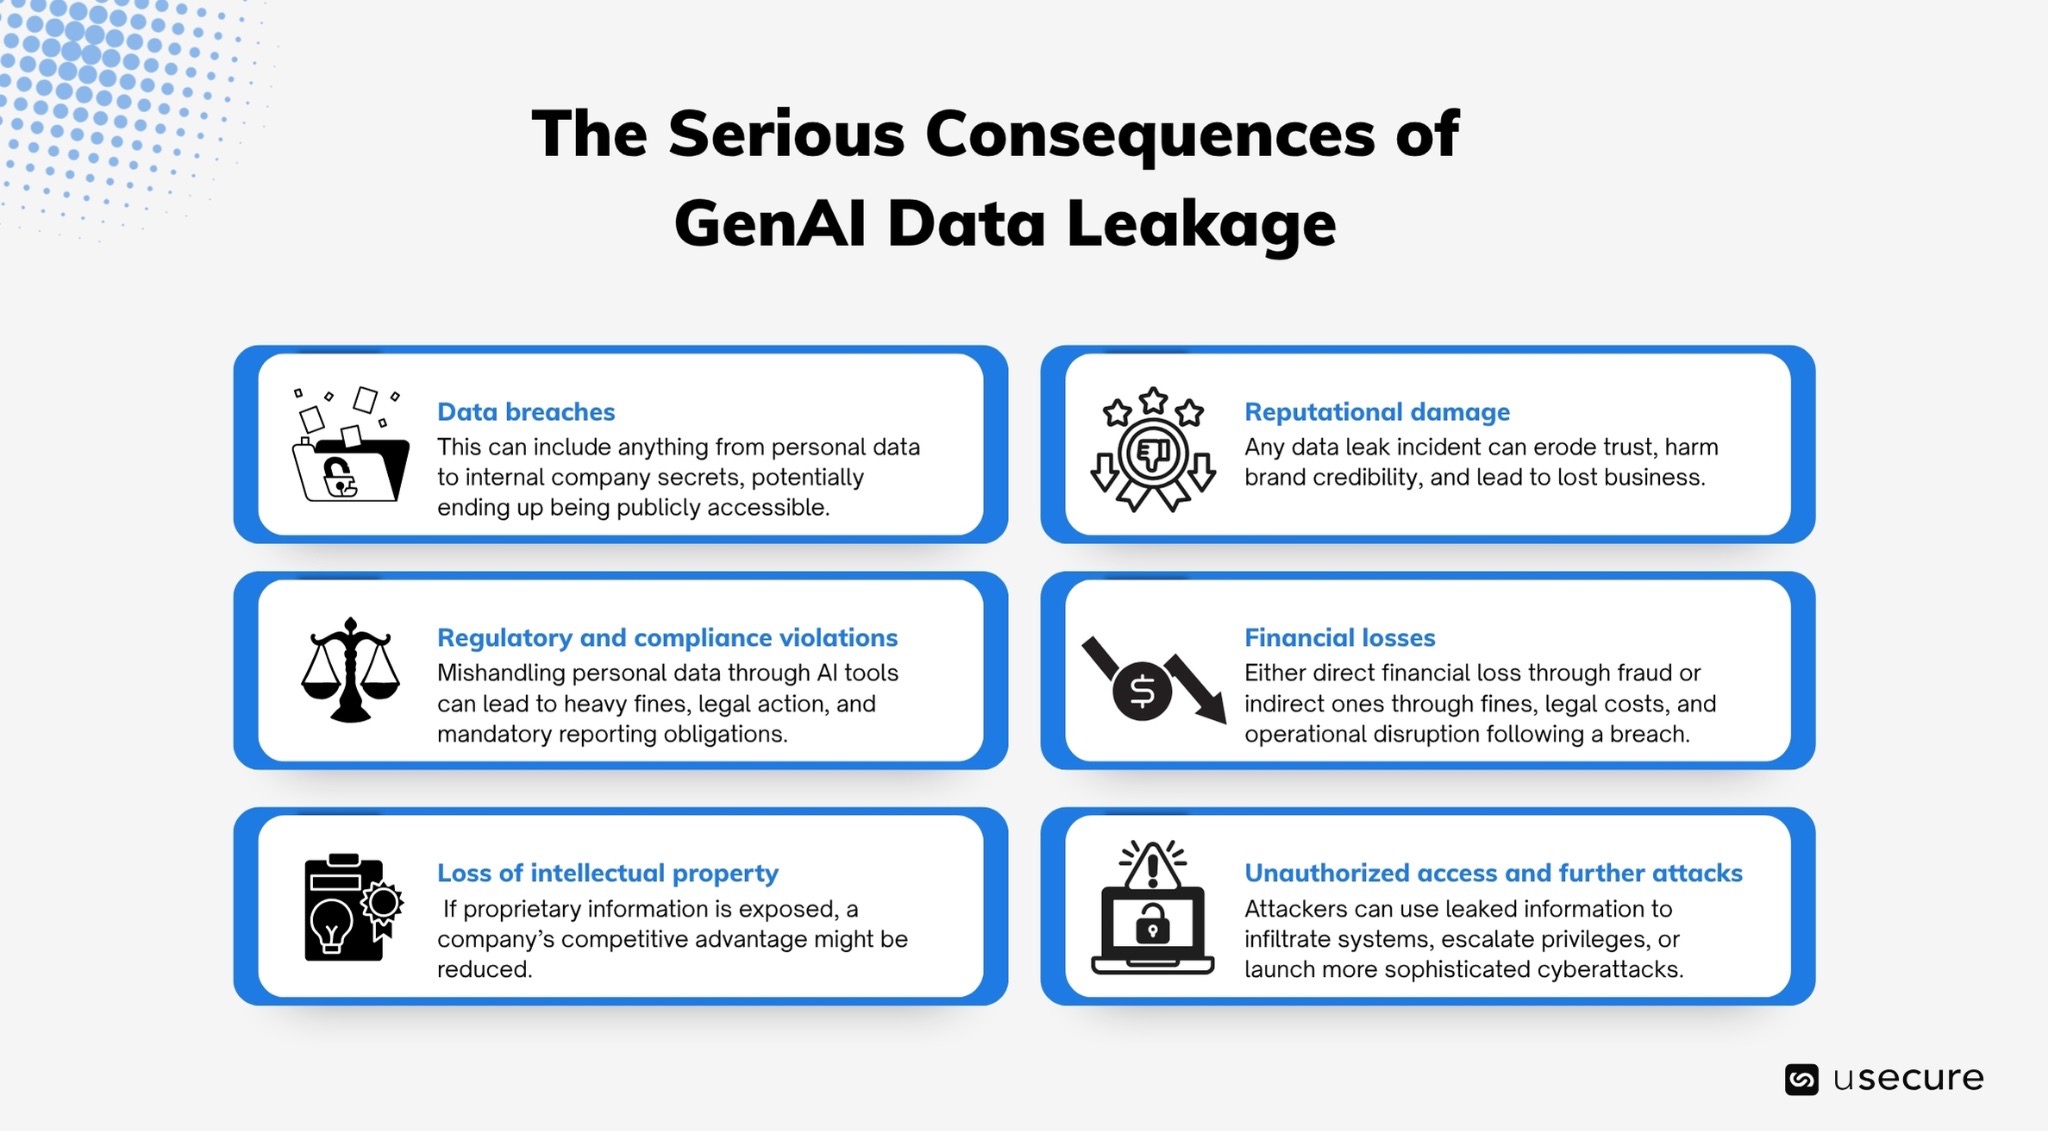
GenAI-Datenlecks können für Einzelpersonen und Unternehmen schwerwiegende und weitreichende Folgen haben.
- Datenschutzverletzungen
Eines der unmittelbarsten Risiken sind Datenschutzverletzungen, bei denen sensible Informationen Unbefugten zugänglich werden. Das reicht von personenbezogenen Daten bis zu internen Geschäftsgeheimnissen, die in die Hände von Angreifern gelangen oder öffentlich einsehbar werden können.
- Verstöße gegen Vorschriften und Compliance-Vorgaben
Hinzu kommen mögliche Verstöße gegen regulatorische und Compliance-Vorgaben. Gesetze wie die GDPR verlangen einen strengen Schutz personenbezogener Daten. Werden diese über KI-Tools unsachgemäß verarbeitet, drohen hohe Bußgelder, rechtliche Schritte und Meldepflichten.
- Verlust von geistigem Eigentum
Eine weitere gravierende Folge ist der Verlust geistigen Eigentums. Werden proprietäre Informationen wie Produktdesigns, Code oder Geschäftsstrategien offengelegt, können Wettbewerber wertvolle Erkenntnisse gewinnen – und der Wettbewerbsvorteil des Unternehmens schrumpft.
- Reputationsschäden
GenAI-Datenlecks können zudem dem Ruf schaden. Kunden und Partner erwarten, dass ihre Daten sicher behandelt werden. Jeder Vorfall kann Vertrauen untergraben, die Glaubwürdigkeit der Marke beschädigen und zu Geschäftsverlusten führen.
- Finanzielle Verluste
In manchen Fällen entstehen finanzielle Verluste – direkt durch Betrug oder indirekt durch Bußgelder, Rechtskosten und Betriebsunterbrechungen nach einem Vorfall.
- Unbefugter Zugriff und Folgeangriffe
Schließlich besteht das Risiko von unbefugtem Zugriff und weiteren Angriffen. Gelangen Zugangsdaten oder Systeminformationen nach außen, können Angreifer damit in Systeme eindringen, ihre Berechtigungen ausweiten oder ausgefeiltere Cyberangriffe starten.
Gartner prognostiziert, dass bis 2030 rund 40 % der Unternehmen von Sicherheitsvorfällen im Zusammenhang mit KI betroffen sein könnten – ein klares Signal, schon heute proaktiv zu handeln.
Das Ausmaß des Problems: Aktuelle Zahlen zeichnen ein besorgniserregendes Bild
Aktuelle Studien aus dem Jahr 2026 zeigen, wie verbreitet GenAI-Datenlecks inzwischen sind:
- 77 % der Mitarbeitenden fügen Daten direkt in GenAI-Tools ein, wobei mehr als 50 % dieser Einfügevorgänge Unternehmensinformationen enthalten. Im Durchschnitt fügt jede Person 6,8-mal pro Tag Inhalte ein, 3,8-mal davon mit sensiblen Daten.
- 26,4 % aller Datei-Uploads in GenAI-Tools enthalten inzwischen sensible Daten (gegenüber 22 % nur drei Monate zuvor). 25 % davon sind technische Daten, und davon wiederum 65 % proprietärer Quellcode.
- 82 % dieser riskanten Einfügevorgänge erfolgen über nicht verwaltete private Konten und umgehen damit sämtliche Unternehmenskontrollen. GenAI ist zum wichtigsten Kanal für die Exfiltration von Unternehmensdaten geworden und macht 32 % aller nicht autorisierten Datenbewegungen aus.
Die Botschaft ist eindeutig: KI-Nutzung ist kein Randphänomen mehr, sondern die neue Normalität.
Beispiele aus der Praxis: Wenn „mal eben die KI fragen“ schiefgeht
- Samsung: Ingenieure fügten vertraulichen Quellcode, Besprechungsprotokolle und Hardware-Spezifikationen in ChatGPT ein, um Fehler zu beheben und Code zu optimieren. Die Daten gelangten in die Systeme von OpenAI – die Folge waren ein sofortiges internes Verbot und eine Überarbeitung der Richtlinien.
- Kanzleien und Gesundheitswesen: Juristen und medizinisches Personal haben versehentlich vertrauliche Mandantendokumente und (selbst „anonymisierte“) Patientendaten in öffentliche LLMs eingegeben und damit Compliance-Prüfungen nach GDPR, HIPAA und berufsethischen Standards ausgelöst.
- Weit verbreitete Vorfälle in Unternehmen: Zahlreiche Unternehmen stellten fest, dass proprietäre Algorithmen, M&A-Unterlagen, Gehaltsdaten und personenbezogene Kundendaten über kostenlose ChatGPT-, Claude- und Perplexity-Konten abgeflossen waren – oft ohne Wissen des Sicherheitsteams.
- Datenleck bei der App Chat & Ask AI: Durch eine falsch konfigurierte Datenbank wurden 300 Millionen Nachrichten von 25 Millionen Nutzern offengelegt – ein Beispiel dafür, wie Apps, die auf KI-Modellen aufsetzen, das Risiko von Datenlecks verstärken.
Der Faktor Mensch als Risikotreiber
Menschliches Verhalten steht im Zentrum von GenAI-Datenlecks. Mitarbeitende übernehmen KI-Tools schnell, weil sie sofort einen Nutzen bringen – unterschätzen aber häufig die Auswirkungen auf Datenschutz und Compliance. Richtlinien hinken der Einführung neuer Tools oft hinterher. So bleiben Datenlecks unkontrolliert, weil Mitarbeitende KI-Tools ohne klare Vorgaben, Schutzmechanismen oder Risikobewusstsein nutzen.
Human Risk Intelligence: Ein entscheidender Schutz vor KI-Datenlecks
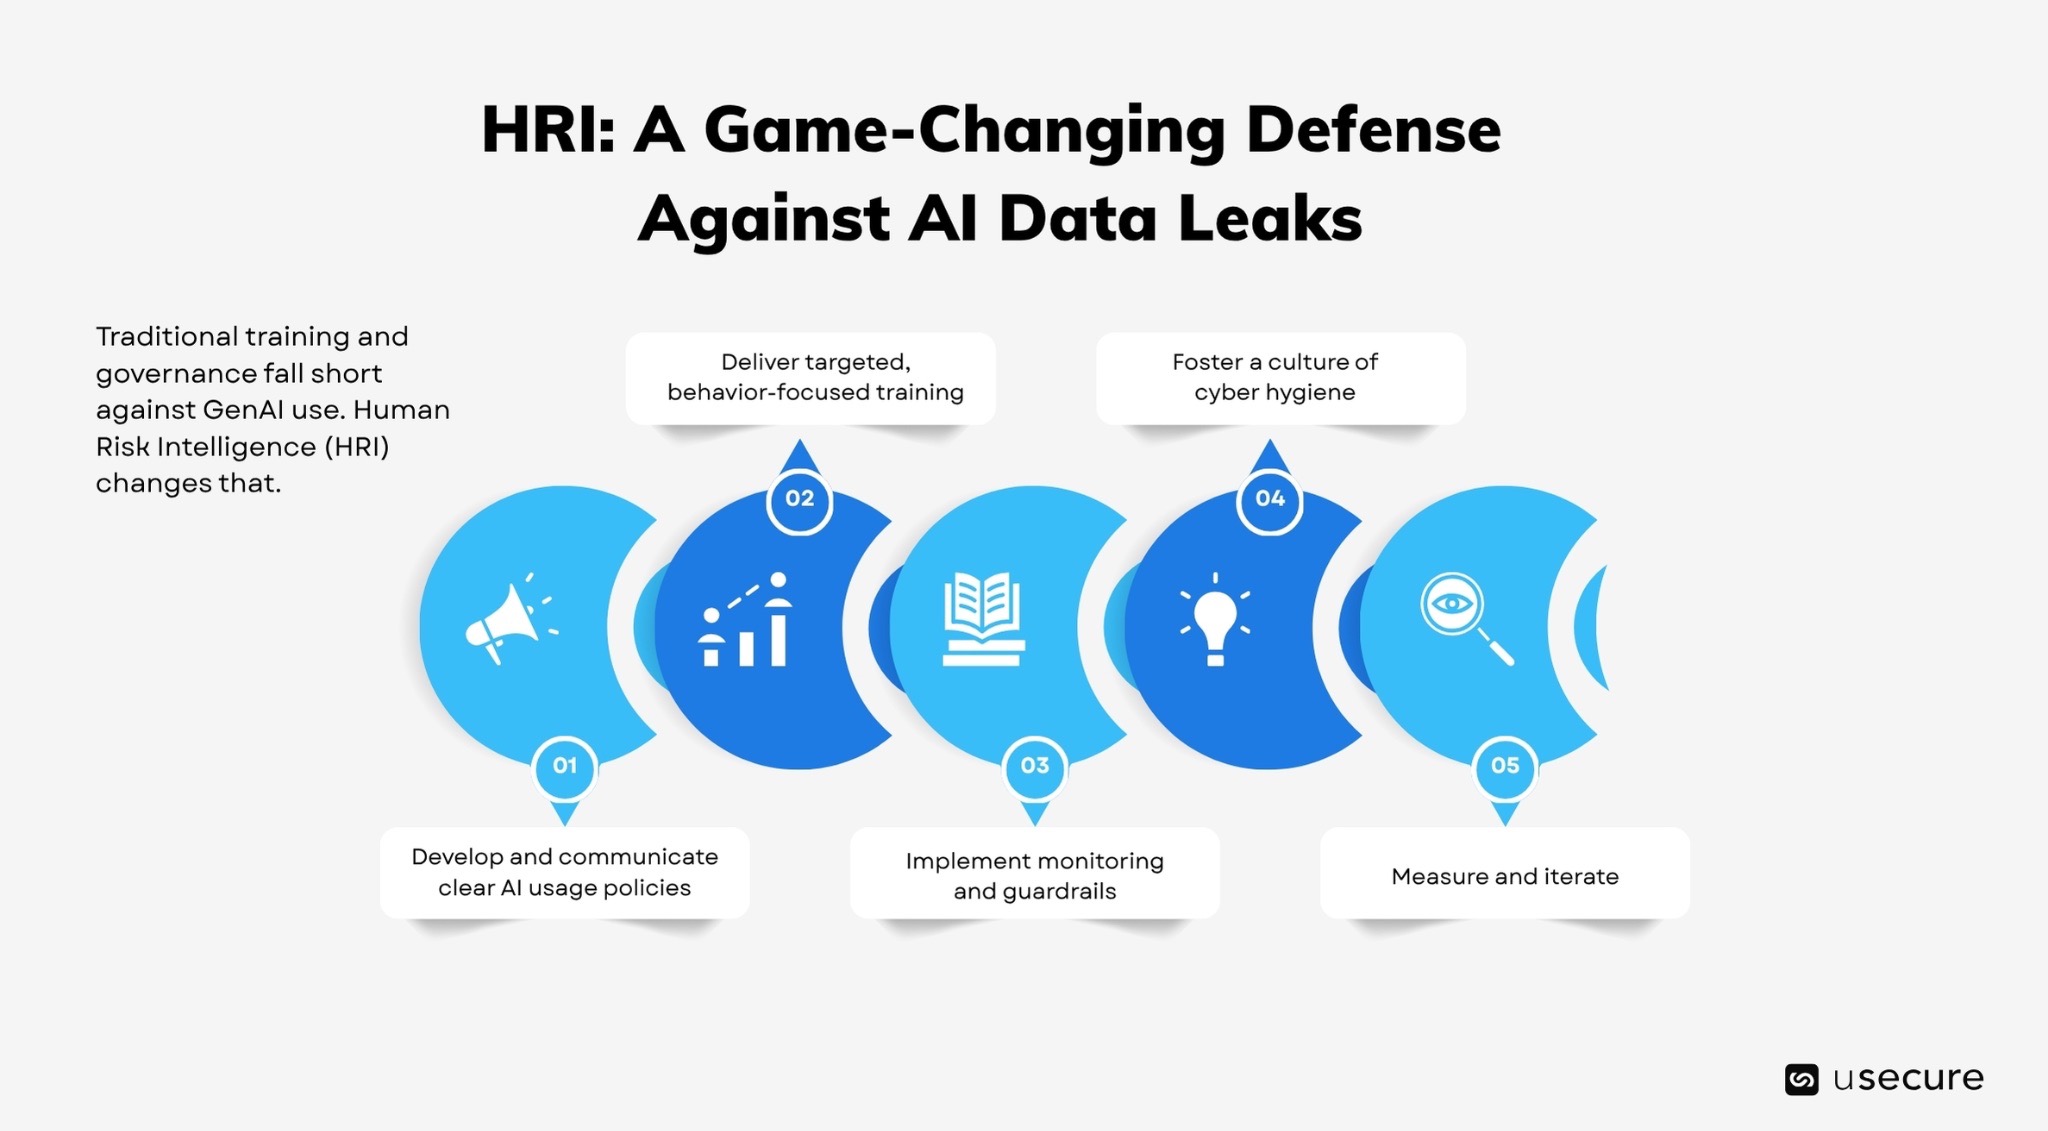
Klassische Schulungen und Governance reichen bei der Nutzung von GenAI nicht aus. Human Risk Intelligence (HRI) ändert das. HRI verbindet Verhaltensdaten, Threat Intelligence und KI-gestützte Analysen, um menschlich bedingte Risiken vorherzusagen und zu verhindern. Unternehmen können ihr Risiko mit einer mehrstufigen Strategie senken:
- Klare KI-Nutzungsrichtlinien festlegen und kommunizieren: Definieren Sie, welche Daten geteilt werden dürfen und welche nicht, und stellen Sie freigegebene Enterprise-Alternativen bereit.
- Gezielte, verhaltensorientierte Schulungen durchführen: Nutzen Sie Erkenntnisse aus Human Risk Intelligence, um Inhalte auf typische Fallstricke wie das Einfügen von Code oder Kundendaten zuzuschneiden.
- Monitoring und Schutzmechanismen einführen: Setzen Sie Lösungen ein, die riskante Muster in Echtzeit erkennen, ohne Arbeitsabläufe unnötig zu stören.
- Eine Kultur der Cyberhygiene fördern: Ermutigen Sie dazu, Beinahe-Vorfälle zu melden, und fördern Sie einen sicheren Umgang mit KI.
- Messen und nachsteuern: Verfolgen Sie Kennzahlen wie Einfügevorfälle, Risikoscores und Schulungswirkung, um Kontrollen kontinuierlich zu verbessern, Richtlinien zu schärfen und die Wahrscheinlichkeit künftiger Datenlecks zu senken.
Mit Human Risk Intelligence können Unternehmen Datenlecks vorhersagen und verhindern, statt erst im Nachhinein zu reagieren.
KI-Nutzung mit HRI steuern
Generative KI bietet enormes Potenzial für Produktivität und Innovation. Doch die unkontrollierte Nutzung öffentlicher Tools durch Mitarbeitende schafft einen erheblichen Angriffsvektor für Datenlecks. Die Zahlen und Beispiele aus 2025–2026 machen deutlich: Das ist kein vorübergehender Trend, sondern ein strukturelles Risiko moderner Arbeitswelten.
Jetzt ist die Zeit zu handeln. Bewerten Sie Ihre aktuelle Gefährdung durch KI-Tools, stärken Sie Richtlinien und Schulungen mit verhaltensbasierten Erkenntnissen und schaffen Sie eine Kultur, in der sichere Praktiken Innovation unterstützen. So machen Sie aus einer potenziellen Schwachstelle einen Wettbewerbsvorteil.
Entdecken Sie den Demo-Hub und erleben Sie unsere Security-Awareness-Lösung sowie die gesamte Human-Risk-Suite in Aktion.
BOOK A DEMO
See Human Risk Intelligence in action
A 30-minute walkthrough of how to cut human risk across your users, tailored to MSPs and IT teams.
Subscribe to newsletter

FAQs
Zu den Kernthemen gehören Phishing, Passwortsicherheit, Multi-Faktor-Authentifizierung (MFA), Social Engineering, sicheres Surfen, Datenschutz und das Melden von Vorfällen. Je nach Rolle können Mitarbeitende zusätzlich Schulungen zu KI-Sicherheit, Datenschutzvorschriften, Finanzbetrug, sicherem Arbeiten im Homeoffice und internen Richtlinien benötigen.
Security Awareness Training sollte kontinuierlich stattfinden und nicht nur als einmaliger Jahreskurs. Unternehmen können Onboarding-Schulungen, regelmäßige Kurzlektionen, themenbezogene Auffrischungen und zusätzliche Schulungen kombinieren, wenn Phishing-Simulationen oder Wissenstests Lücken aufzeigen.
uLearn von usecure ermittelt das Sicherheitswissen jedes Benutzers und weist über Auto Enrol Schulungen passend zu den erkannten Wissenslücken zu. Automatische Kursplanung, Erinnerungen und Reporting helfen Unternehmen, ein kontinuierliches Programm mit weniger manuellem Verwaltungsaufwand umzusetzen.
Ja. usecure bietet eine kostenlose 14-tägige Testversion seiner zentralen Human Risk Management Plattform an – mit Security Awareness Training, Phishing-Simulationen, Richtlinienmanagement und der Prüfung offengelegter Zugangsdaten.
Related posts
Explore more insights, updates, and resources from usecure.

AI Threat Trends 2026: The Human-Layer Attacks AI Is Making Cheaper

AI-Powered Phishing and Spear Phishing: Use Human Risk Intelligence As Your Defense
Prompt Injection und Missbrauch von KI-Assistenten: Wenn Mitarbeitende KI-Tools in sensiblen Workflows nutzen
See effortless human risk intelligence in action
Book a demo to see how usecure reduces human risk for IT teams and MSPs, or start a free trial to explore the platform yourself.

